Sommaire
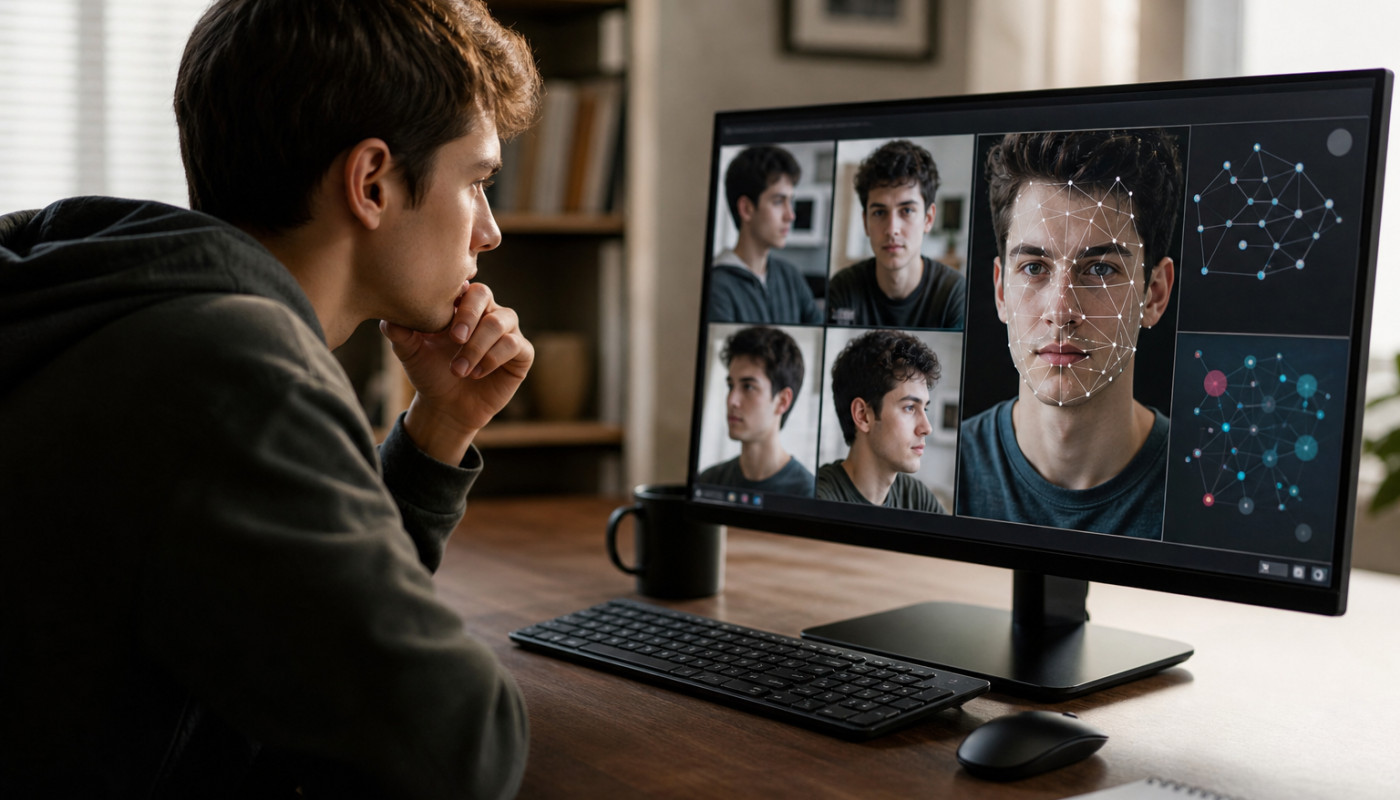
Un selfie, une photo de soirée, un montage sur Instagram : et si ces images disaient plus sur un étudiant que ses notes et son CV ? Dans les laboratoires, des modèles d’intelligence artificielle apprennent déjà à relier certains indices visuels à des traits de personnalité, avec des résultats parfois troublants. À l’heure où les universités numérisent leurs services et où les recruteurs scrutent les traces en ligne, la promesse fascine, mais elle inquiète aussi, car derrière la « lecture » des images se jouent des enjeux de science, de biais et de vie privée.
Des photos aux traits : la promesse fragile
Peut-on vraiment « lire » quelqu’un en pixels ? La recherche en psychologie et en vision par ordinateur s’y essaie, en s’appuyant sur des jeux de données où des participants associent leurs images à des questionnaires standardisés, le plus souvent basés sur le modèle des Big Five, c’est-à-dire l’ouverture à l’expérience, la conscience, l’extraversion, l’agréabilité et le neuroticisme. L’idée n’est pas neuve, mais la puissance de calcul et l’apprentissage profond ont changé d’échelle, en permettant d’entraîner des réseaux neuronaux sur des milliers, parfois des dizaines de milliers de visages, de scènes et de styles photographiques.
Dans une étude devenue référence, publiée en 2017 dans Proceedings of the National Academy of Sciences (PNAS), des chercheurs affirmaient qu’un algorithme pouvait distinguer l’orientation sexuelle à partir de photos de visage avec une précision élevée sur leur échantillon, un résultat qui a déclenché une controverse mondiale sur l’inférence de traits sensibles. La même année, d’autres travaux, notamment dans le sillage de la psychologie computationnelle, ont exploré le lien entre l’apparence, les choix d’images sur les réseaux sociaux et des dimensions de personnalité, avec une conclusion récurrente : des signaux existent, mais ils sont très dépendants du contexte, de la culture, du cadrage et de la qualité des données.
Appliqué à la « personnalité d’un étudiant », le sujet se complique encore. Les images d’un étudiant ne montrent pas seulement son visage : elles captent aussi un environnement social, des codes vestimentaires, un campus, un filtre, une mise en scène, et donc une stratégie de présentation de soi. Or, en psychologie sociale, on sait que l’identité affichée n’est pas l’identité vécue, et que les normes de groupe pèsent sur ce que l’on publie. L’IA peut alors détecter une esthétique, un style de vie présumé, un milieu, et confondre ces signaux avec un trait de personnalité. La promesse, séduisante sur le papier, reste fragile dès qu’on la sort du laboratoire.
Ce que l’IA « voit », et ce qu’elle invente
Attention aux certitudes rapides. Un modèle de vision ne « comprend » pas une personne : il optimise des corrélations. Concrètement, il transforme une image en une multitude de variables, couleurs, textures, formes, micro-contrastes, puis apprend à associer ces variables à une étiquette fournie pendant l’entraînement, par exemple « extraverti » ou « introverti », souvent dérivée d’un questionnaire. Si, dans les données, les étudiants plus extravertis publient davantage de photos de groupe, de scènes de fête ou d’activités sportives, l’algorithme peut s’accrocher à ces motifs, et produire ensuite des prédictions qui ressemblent à des jugements de personnalité, alors qu’il s’agit parfois d’un simple repérage de contexte.
La littérature scientifique alerte depuis longtemps sur un biais central : les modèles apprennent aussi les inégalités du monde réel. Une base d’images surreprésentant certaines origines, certains genres ou certains milieux sociaux peut conduire à des prédictions moins fiables, voire discriminatoires, pour les groupes minoritaires. Dans un autre domaine, l’analyse des visages, une étude du NIST (National Institute of Standards and Technology), publiée en 2019 sur les tests de reconnaissance faciale, montrait des écarts de performance marqués selon l’origine et le sexe, signe que les systèmes visuels ne sont pas neutres, et que la qualité des données d’entraînement façonne les résultats. Transposée à la personnalité, cette leçon compte double : il est plus difficile encore d’établir une « vérité » de référence, et donc d’évaluer l’erreur.
Reste un point souvent mal compris : même lorsque des performances statistiques semblent correctes, elles ne garantissent pas une pertinence individuelle. Une précision moyenne, sur un échantillon donné, peut masquer des erreurs importantes pour des personnes particulières, surtout si l’on change de population, de pays, d’âge ou de plateforme. Un modèle calibré sur des images LinkedIn ne se comportera pas comme un modèle entraîné sur Instagram, et un étudiant qui publie peu ou qui compartimente ses comptes brouille les cartes. Autrement dit, l’IA « voit » des indices, mais elle peut aussi inventer des récits plausibles à partir de signaux faibles, et transformer une probabilité en verdict, ce qui, dans un cadre éducatif, devient vite explosif.
Campus et recruteurs : la tentation du tri
Le risque, c’est le glissement d’usage. Dans l’enseignement supérieur, la pression sur l’orientation, le suivi des étudiants et la prévention du décrochage alimente l’idée d’outils capables de repérer des profils « à risque » ou des besoins d’accompagnement, parfois à partir de données numériques hétérogènes. Les images, parce qu’elles sont abondantes et faciles à collecter, peuvent sembler une mine, notamment dans des environnements où l’on confond engagement en ligne et engagement académique. Mais dès qu’une prédiction de personnalité intervient dans une décision, admission, attribution de bourse, sélection pour un programme, l’enjeu n’est plus technique : il devient politique.
Du côté des entreprises, la tentation existe aussi. Depuis des années, certains acteurs du recrutement promettent des évaluations automatisées, en analysant expressions faciales, tonalité, posture, ou « signaux » dans des vidéos d’entretien, au nom d’une objectivité supposée. Or, en 2021, l’ONG AlgorithmWatch publiait une enquête critiquant la validité scientifique et la transparence de certains outils d’analyse émotionnelle et comportementale utilisés au travail. Plusieurs chercheurs en sciences cognitives et en IA soulignent qu’inférer des traits internes stables à partir d’indices visuels est une ambition fragile, car l’expression dépend du contexte, de la culture et du stress, et parce que les catégories utilisées sont souvent simplifiées.
Pour un étudiant, l’enjeu est immédiat : une photo peut devenir un signal sans consentement explicite, et l’interprétation peut s’ancrer durablement. L’effet de halo, bien connu en psychologie, amplifie la menace : une impression initiale, produite par un modèle, peut influencer d’autres jugements, motivation, leadership, « sérieux », et verrouiller une trajectoire. La question n’est donc pas seulement « est-ce possible ? », mais « à quel prix ? », et surtout « qui contrôle le modèle, les données et les usages ? ». Pour comprendre comment certaines organisations communiquent sur leurs travaux et leurs orientations autour de l’IA, on peut cliquer ici maintenant.
Mesurer, encadrer, et garder l’humain au centre
Alors, que faire de cette technologie ? D’abord, exiger des preuves. Un système qui prétend inférer la personnalité devrait publier sa méthodologie, la composition de ses jeux de données, ses métriques, et ses limites, avec des tests de robustesse, c’est-à-dire des évaluations sur d’autres populations, d’autres cultures, d’autres conditions d’image. Il devrait aussi distinguer clairement ce qui relève d’un trait stable et ce qui relève d’un contexte de publication, car une photo de remise de diplôme ne dit pas la même chose qu’une photo de vacances. Sans cette transparence, la « personnalité via images » reste une narration marketing plus qu’un résultat scientifique.
Ensuite, encadrer l’usage, car le droit européen pose déjà des jalons. Le RGPD classe les données biométriques comme sensibles lorsqu’elles servent à identifier une personne, et il encadre fortement le traitement des données à caractère personnel, avec des exigences de finalité, de minimisation et d’information. Plus largement, l’AI Act européen, adopté en 2024, introduit une approche par les risques, et impose des obligations renforcées pour certains systèmes à « haut risque », notamment dans l’éducation et l’emploi, avec des exigences de gouvernance des données, de documentation, de supervision humaine et de transparence. Même si toutes les inférences de personnalité ne tombent pas mécaniquement dans la même catégorie, l’esprit du texte est clair : on ne déploie pas impunément des modèles qui peuvent impacter l’avenir des personnes.
Enfin, préserver l’humain. Les universités ont intérêt à privilégier des dispositifs d’accompagnement explicables, co-construits avec les étudiants, et limités à des objectifs légitimes, par exemple détecter des difficultés académiques à partir de signaux pédagogiques, plutôt que d’inférer des traits intimes depuis des images. La personnalité est un concept utile en psychologie, mais il n’est pas un score universel, et encore moins un instrument d’orientation automatisée. L’IA peut aider à analyser des corpus et à identifier des tendances, mais elle ne doit pas devenir un oracle, surtout lorsque ce qu’elle « devine » peut coller à la peau.
Avant de juger, demander des garanties
Avant de confier des images à un outil, l’étudiant doit vérifier la finalité, la durée de conservation et le droit de retrait, et l’établissement doit documenter le modèle, ses données et sa supervision humaine. Côté budget, mieux vaut financer l’accompagnement que l’automatisation, et mobiliser les aides numériques existantes via les dispositifs publics et les services étudiants.
Sur le même sujet
Contact client : l’importance du dialogue dans la réussite des projets d’agencement
Pourquoi l’abonnement bouleverse la publicité à l’ère de l’intelligence artificielle

Comment maximiser l'efficacité des réunions virtuelles en entreprise ?

Comment les chatbots transforment-ils le service client en ligne ?

Comment choisir une agence pour des projets web personnalisés ?

Comment un suivi personnalisé peut transformer la stratégie web de votre TPE ?

Comment les sites sur-mesure surpassent les CMS traditionnels ?

Maximiser l'impact de votre événement : le choix crucial de la salle

Comment les animations mobiles révolutionnent les événements en région parisienne ?
